
robots.txt 검색봇 차단 방법
검색봇으로 인해 트래픽 증가가 발생,
사이트가 차단되는 경우가 많은데 이럴때 해결방법을 알려 드리겠습니다.
말 그대로 검색봇을 손쉽게 차단하는 방법을 알려드리겠습니다.
호스팅을 사용하다 보면 갑자기 트래픽 사용량이 증가해 차단이 되는 경우가 많습니다.
이럴 경우 다음과 같이 따라 하시면 됩니다.
호스팅을 이용하다 보면 검색봇의 반복적인 사이트 접속으로 트래픽 사용량이 증가하여 사이트가 일시적으로 차단되는 경우가 있습니다.
이 경우 접속 로그를 통해 트래픽이 많이 발생하는 IP를 확인하고, 검색엔진의 크롤링이 원인이라면 robots.txt 파일을 이용하여 검색봇의 사이트 접근을 제한할 수 있습니다.
아래 방법을 순서대로 확인해 주세요.
웹로그를 통해 접속 IP 확인하기
트래픽 사용량이 갑자기 증가하여 사이트가 차단된 경우, 먼저 닷홈에서 제공하는 웹로그를 통해 어떤 IP에서 접속이 많이 발생했는지 확인합니다.
웹로그를 확인하면 특정 IP에서 반복적으로 접속하거나 대량의 요청을 발생시키는 경우를 확인할 수 있습니다.
참고: 웹로그 확인 방법은 아래 내용을 참고해 주세요.
닷홈 웹로그 확인 방법
접속 IP를 확인한 후 해당 IP가 검색엔진의 크롤러인지 확인합니다.
1.검색봇으로 웹로그인한 통한 IP트래픽인지 확인하기
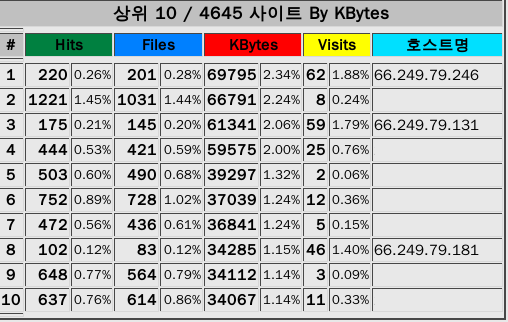
먼저웹로그에서 트래픽특정 사용량이IP의 증가해접속이 사이트가반복적으로 차단된확인되는 경우, 해당 IP가 검색엔진의 검색봇인지 확인할 수 있습니다.
예를 들어 다음과 같이 66.249.79.* 대역의 IP가 반복적으로 접속하는 경우 Google 검색봇과 관련된 IP일 수 있습니다.
닷홈에서검색봇으로 제공하는인해 웹로그에서불필요한 접속이트래픽이 많은지속적으로 IP를발생하거나, 먼저홈페이지를 확인해검색엔진에 볼수노출하고 싶지 않은 경우에는 robots.txt 파일을 이용하여 검색봇의 크롤링을 제한할 수 있습니다.
주의:
robots.txt는 검색로봇에게 크롤링하지 않도록 요청하는 방법입니다. 악성 봇이나 일반적인 IP의 접속을 강제로 차단하는 기능은 아닙니다.
robots.txt 파일 만들기
검색봇의 접근을 제한하려면 메모장 등의 텍스트 편집기를 이용하여 robots.txt 파일을 생성합니다.
참고작성한 :robots.txt 파일은 홈페이지의 최상위 디렉터리에 업로드해야 합니다.
즉, 홈페이지의 index.html, index.php 등의 파일이 있는 위치에
혹시robots.txt를 조금업로드하면 모르겠다면 위의 내용을 조금 더 보고 다음 글을 읽어주세요!!됩니다.
2. 트래픽 확인하고 처리하기
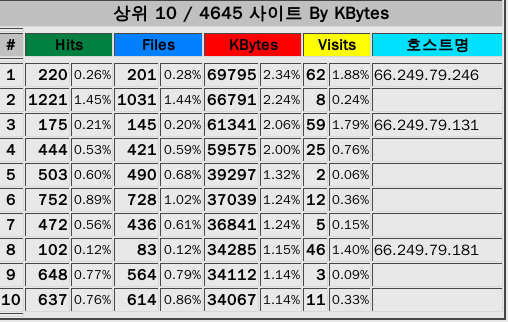
사진 설명을 입력하세요.
위와 같이 66.249.79.*로 되어 있는 IP는 구글의 검색봇 IP 입니다.
검섹엔진 봇으로 인해 불필요한 트래픽 낭비를 줄이거나 홈페이지
노출을 꺼리는 경우 robots.txt 파일을 만들어 FTP로 업로드 후 차단할수 있습니다.
업로드 위치는 index 파일이 위치한 웹사이트의 최상위 디렉토리입니다.
닷홈의 기준으로는 /html입니다.
# 사용 예제
모든 검색로봇 접근 차단
User-agent: *
Disallow: /
모든 검색로봇 접근 허용
User-agent: *
Allow: /
구글 검색로봇 차단
User-agent: Googlebot
Disallow: /
네이버 검색로봇만 접근 허용
User-agent:Yeti
Allow: /
User-agent: *
Disallow: /
특정 디렉토리만 검색로봇 차단
User-agent: *
Disallow: / 디렉토리명
자주 사용하는 내용만 올렸습니다.
자세한 사용 방법은 http://www.robotstxt.org 에서 확인이 가능합니다. 아래 예제는 자주 사용되는 예제입니다.
① 모든 검색로봇의 접근 차단
홈페이지 전체를 검색엔진에서 크롤링하지 못하도록 설정하려면 다음과 같이 작성합니다.
User-agent: *
Disallow: /*는 모든 검색로봇을 의미하며, /는 홈페이지 전체를 의미합니다.
② 모든 검색로봇의 접근 허용
모든 검색로봇이 홈페이지를 크롤링할 수 있도록 하려면 다음과 같이 작성합니다.
User-agent: *
Allow: /③ Google 검색로봇만 차단
Google 검색로봇의 접근만 차단하려면 다음과 같이 작성합니다.
User-agent: Googlebot
Disallow: /
④ 네이버 검색로봇만 허용
네이버 검색로봇인 Yeti의 접근은 허용하고, 그 외 검색로봇의 접근은 차단하려면 다음과 같이 설정할 수 있습니다.
User-agent: Yeti
Allow: /

User-agent: *
Disallow: /
⑤ 특정 디렉터리만 차단
홈페이지 전체가 아니라 특정 디렉터리만 검색로봇이 접근하지 못하도록 설정할 수도 있습니다.
예를 들어 /test/ 디렉터리의 크롤링을 차단하려면 다음과 같이 작성합니다.
User-agent: *
Disallow: /test/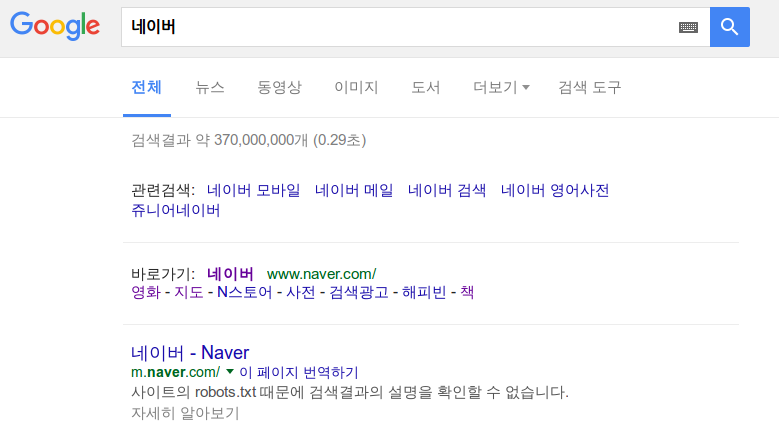
사진 설명을 입력하세요.
위를 보시면 구글에서 네이버 검색시 robots.txt 가 적용되어 있는 모습을 보실수 있습니다.