# robots.txt 검색봇 차단 방법

<span class="se-ff-nanumgothic se-fs16 __se-node" id="bkmrk-%EA%B2%80%EC%83%89%EB%B4%87%EC%9C%BC%EB%A1%9C-%EC%9D%B8%ED%95%B4-%ED%8A%B8%EB%9E%98%ED%94%BD-%EC%A6%9D%EA%B0%80%EA%B0%80-%EB%B0%9C%EC%83%9D%2C-1"></span>

<span class="se-ff-nanumgothic se-fs15 __se-node" id="bkmrk--5"></span>

<span class="se-ff-nanumgothic se-fs15 __se-node" id="bkmrk--7"></span>

<span class="se-ff-nanumgothic se-fs16 __se-node" id="bkmrk-%ED%98%B8%EC%8A%A4%ED%8C%85%EC%9D%84-%EC%82%AC%EC%9A%A9%ED%95%98%EB%8B%A4-%EB%B3%B4%EB%A9%B4-%EA%B0%91%EC%9E%90%EA%B8%B0-%ED%8A%B8%EB%9E%98%ED%94%BD-1">호스팅을 사용하다 보면 갑자기 트래픽 사용량이 증가해 차단이 되는 경우가 많습니다.</span>

<span class="se-ff-nanumgothic se-fs15 __se-node" id="bkmrk--9"></span>

<span class="se-ff-nanumgothic se-fs16 __se-node" id="bkmrk-%EC%9D%B4%EB%9F%B4-%EA%B2%BD%EC%9A%B0-%EB%8B%A4%EC%9D%8C%EA%B3%BC-%EA%B0%99%EC%9D%B4-%EB%94%B0%EB%9D%BC-%ED%95%98%EC%8B%9C%EB%A9%B4--1">이럴 경우 다음과 같이 따라 하시면 됩니다.</span>

호스팅을 이용하다 보면 **검색봇의 반복적인 사이트 접속으로 트래픽 사용량이 증가하여 사이트가 일시적으로 차단되는 경우**가 있습니다.

이 경우 접속 로그를 통해 트래픽이 많이 발생하는 IP를 확인하고, 검색엔진의 크롤링이 원인이라면 `robots.txt` 파일을 이용하여 검색봇의 사이트 접근을 제한할 수 있습니다.

아래 방법을 순서대로 확인해 주세요.

#### **<span style="color: rgb(230, 126, 35);">웹로그를 통해 접속 IP 확인하기</span>**

  
트래픽 사용량이 갑자기 증가하여 사이트가 차단된 경우, 먼저 **닷홈에서 제공하는 웹로그**를 통해 어떤 IP에서 접속이 많이 발생했는지 확인합니다.

웹로그를 확인하면 특정 IP에서 반복적으로 접속하거나 대량의 요청을 발생시키는 경우를 확인할 수 있습니다.

> **참고:** 웹로그 확인 방법은 아래 내용을 참고해 주세요.  
> <span class="contents" data-content-reference-end="637" data-content-reference-start="573"><span class="" data-state="closed">[닷홈 웹로그 분석 가이드](https://docs.dothome.co.kr/books/faq-nCD/page/weblog)</span></span>

접속 IP를 확인한 후 해당 IP가 검색엔진의 크롤러인지 확인합니다.

<span class="se-ff-nanumgothic se-fs15 __se-node" id="bkmrk--12"></span>

<span class="se-ff-nanumgothic se-fs15 __se-node" id="bkmrk--14"></span>

<span class="se-ff-nanumgothic se-fs15 __se-node" id="bkmrk--16"></span>

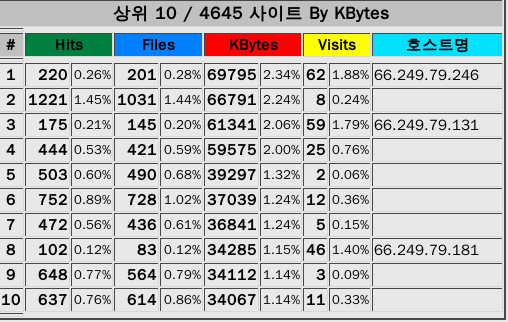
#### **<span style="color: rgb(230, 126, 35);">검색봇으로 인한 트래픽인지 확인하기</span>**

[![1.png](https://docs.dothome.co.kr/uploads/images/gallery/2026-09/scaled-1680-/1.png)](https://docs.dothome.co.kr/uploads/images/gallery/2026-09/1.png)

웹로그에서 특정 IP의 접속이 반복적으로 확인되는 경우, 해당 IP가 검색엔진의 검색봇인지 확인할 수 있습니다.

예를 들어 다음과 같이 **`66.249.79.*` 대역의 IP**가 반복적으로 접속하는 경우 Google 검색봇과 관련된 IP일 수 있습니다.

검색봇으로 인해 불필요한 트래픽이 지속적으로 발생하거나, 홈페이지를 검색엔진에 노출하고 싶지 않은 경우에는 `robots.txt` 파일을 이용하여 검색봇의 크롤링을 제한할 수 있습니다.

> **주의:** `robots.txt`는 검색로봇에게 크롤링하지 않도록 요청하는 방법입니다. 악성 봇이나 일반적인 IP의 접속을 강제로 차단하는 기능은 아닙니다.

#### <span style="color: rgb(230, 126, 35);">**robots.txt 파일 만들기**</span>

  
검색봇의 접근을 제한하려면 메모장 등의 텍스트 편집기를 이용하여 **`robots.txt`** 파일을 생성합니다.

작성한 `robots.txt` 파일은 **홈페이지의 최상위 디렉터리**에 업로드해야 합니다.

즉, 홈페이지의 `index.html`, `index.php` 등의 파일이 있는 위치에<span class="se-ff-nanumgothic se-fs16 __se-node" id="bkmrk-%EC%97%85%EB%A1%9C%EB%93%9C-%EC%9C%84%EC%B9%98%EB%8A%94-index-%ED%8C%8C%EC%9D%BC%EC%9D%B4-%EC%9C%84%EC%B9%98-1"> </span> `robots.txt`를 업로드하면 됩니다.

#### <span style="color: rgb(230, 126, 35);">**robots.txt 사용 예제**</span>

<span class="se-ff-nanumgothic se-fs16 __se-node" id="bkmrk-%EC%9E%90%EC%84%B8%ED%95%9C-%EC%82%AC%EC%9A%A9-%EB%B0%A9%EB%B2%95%EC%9D%80">자세한 사용 방법은 </span><span class="se-ff-nanumgothic se-fs16 se-link __se-node" data-href="http://www.robotstxt.org" id="bkmrk-http%3A%2F%2Fwww.robotstxt">http://www.robotstxt.org</span><span class="se-ff-nanumgothic se-fs16 __se-node" id="bkmrk-%EC%97%90%EC%84%9C-%ED%99%95%EC%9D%B8%EC%9D%B4-%EA%B0%80%EB%8A%A5%ED%95%A9%EB%8B%88%EB%8B%A4."> 에서 확인이 가능합니다. 아래 예제는 자주 사용되는 예제입니다.</span>

  
① 모든 검색로봇의 접근 차단

홈페이지 전체를 검색엔진에서 크롤링하지 못하도록 설정하려면 다음과 같이 작성합니다.

```
User-agent: *
Disallow: /
```

`*`는 모든 검색로봇을 의미하며, `/`는 홈페이지 전체를 의미합니다.

② 모든 검색로봇의 접근 허용

모든 검색로봇이 홈페이지를 크롤링할 수 있도록 하려면 다음과 같이 작성합니다.

```
User-agent: *
Allow: /
```

<div class="relative w-full mt-4 mb-1" id="bkmrk--3"><div class=""><div class="contents"><div class="relative">  
</div></div></div></div>③ Google 검색로봇만 차단

Google 검색로봇의 접근만 차단하려면 다음과 같이 작성합니다.

```
User-agent: Googlebot
Disallow: /
```

<div class="relative w-full mt-4 mb-1" id="bkmrk--17"><div class=""><div class="contents">  
</div></div></div>④ 네이버 검색로봇만 허용

네이버 검색로봇인 `Yeti`의 접근은 허용하고, 그 외 검색로봇의 접근은 차단하려면 다음과 같이 설정할 수 있습니다.

```
User-agent: Yeti
Allow: /

User-agent: *
Disallow: /
```

<div class="relative w-full mt-4 mb-1" id="bkmrk--18"><div class=""><div class="contents"><div class="relative">  
</div></div></div></div>⑤ 특정 디렉터리만 차단

홈페이지 전체가 아니라 특정 디렉터리만 검색로봇이 접근하지 못하도록 설정할 수도 있습니다.

예를 들어 `/test/` 디렉터리의 크롤링을 차단하려면 다음과 같이 작성합니다.

```
User-agent: *
Disallow: /test/
```

<div class="relative w-full mt-4 mb-1" id="bkmrk--19"><div class=""><div class="contents">  
</div></div></div><div class="se-component se-text se-l-default" data-a11y-title="본문" data-compid="SE-858c9c90-af85-11ee-afe6-af0abf635ded" id="bkmrk--89"><div class="se-component-content"><div class="se-drop-indicator" data-compid="SE-858c9c90-af85-11ee-afe6-af0abf635ded" data-direction="top" data-unitid=""><div class="se-section se-section-text se-l-default se-is-focused"><div class="se-module se-module-text __se-unit" id="bkmrk--90"></div></div></div></div></div>